一、花指令的核心原理
花指令(Junk Code / Obfuscation)的本质是:
不改变程序原本的真实运行逻辑,但通过插入无效字节、改变指令流或制造指令错位,使 IDA、Ghidra 等反编译工具的静态分析工作陷入瘫痪或解析出错。
二、反编译器的扫描机制与盲区
反编译工具通常有两种扫描模式,而花指令正是针对这两种模式设计的:
1. 线性扫描 (Linear Sweep)
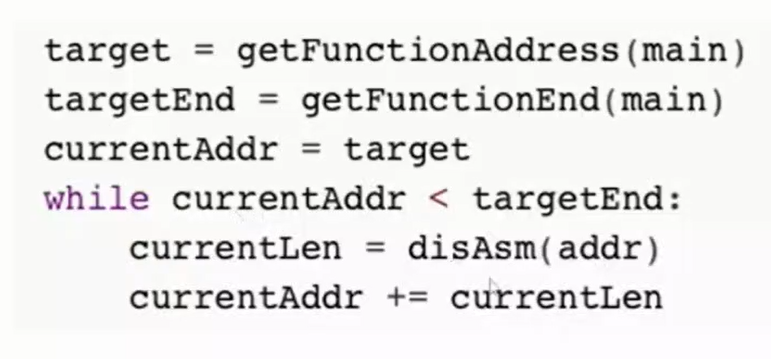
原理:从代码段起始位置开始,逐字节或逐指令往下扫描,遇到分支指令(如 call、jmp)不递归进入分支,而是继续扫描下一条物理地址。
盲区:如果在跳转指令下面接一些垃圾数据,反汇编器会把垃圾数据也当成代码去解析,导致后续指令全部错位。
2. 递归下降 (Recursive Descent)
原理:从程序入口点(Entry Point)开始,顺着控制流进行扫描。遇到 call 会进入函数,遇到 jmp 会跟着跳转。
盲区:遇到条件跳转(JCC)时,反编译器会认为两个分支都有可能走,因此两个分支都会去反汇编。如果在其中一个分支里塞满垃圾数据(或者指令错位),就会导致反编译崩溃。
三、常见花指令的构造手法
1. 干扰指令长度 (指令错位)
反编译工具在解析时,通常会读取一个 currentLen(当前指令长度),然后 当前地址 += currentLen 来解析下一条指令。
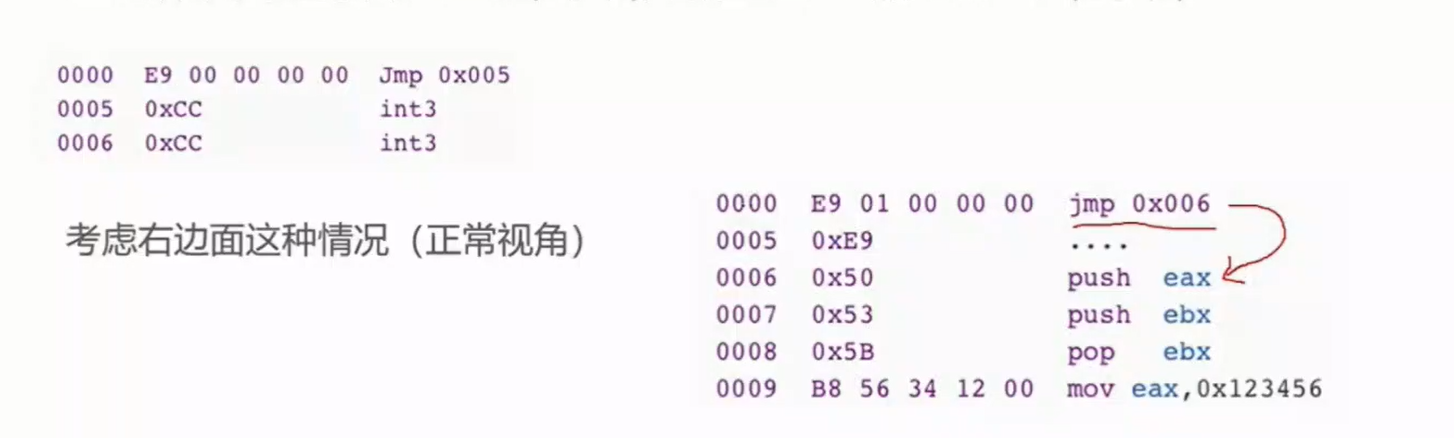
- JMP 错位:比如
jmp的字节码是0xE9,后面跟 4 字节相对偏移(目标地址 - 当前地址 - 5)。 
- 构造方式:如视频演示图,正常的跳转本应跳到目标位置。但如果利用
0xE9等操作码的字节重叠,让工具错误地识别了下一条指令的起点,就会导致后续反汇编顺序全乱。
2. 永真/永假条件跳转
为了对付递归下降,出题人会构造必定成立或不成立的条件跳转。
- 构造方式:比如前面写一个
xor eax, eax(清零,使 ZF=1),紧接着写一个je label(必定跳转)。然后在je下方塞入垃圾数据。 - 特征识别:由于构造永真/永假式可能会影响寄存器状态,出题人通常会在前面加
push保存寄存器,跳转后再pop还原(栈平衡)。这也是识别花指令的重要特征。
3. 间接跳转 (动态地址计算)
利用 call 压栈返回地址的特性,动态计算跳转目标。
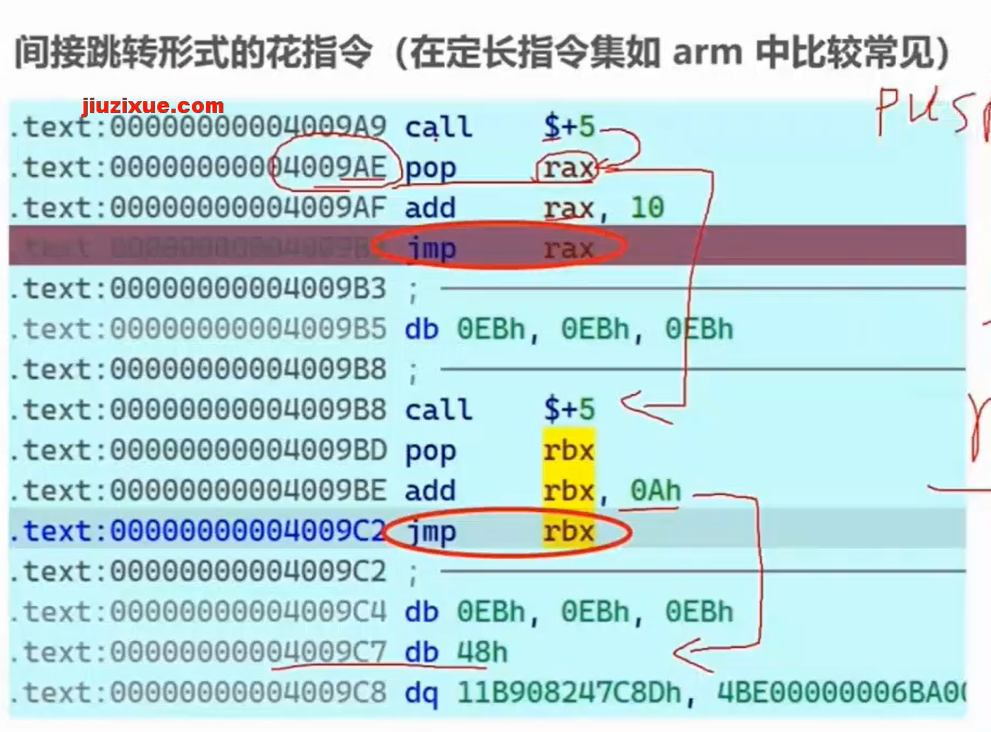
- 构造方式:如视频演示图,
call $+5将下一行地址压栈,pop rax取出地址,经过add偏移计算后,直接jmp rax跳出垃圾指令区。 - 手工去除法:把这一整块数据 Dump 出 Hex,用等长的
0x90(NOP)在 010 Editor 等工具中替换覆盖。
4. 指令复用 (跳入指令中间)
- 构造方式:跳转到某一条多字节指令的中间部分,将后半段作为新指令的起始(重叠指令)。经过巧妙构造,可以从原本无意义的字节中解析出一条新的跳转指令跳出。这会让线性扫描彻底失效。
四、实战案例分析(原样保留)
比如这道 [HDCTF2019]Maze
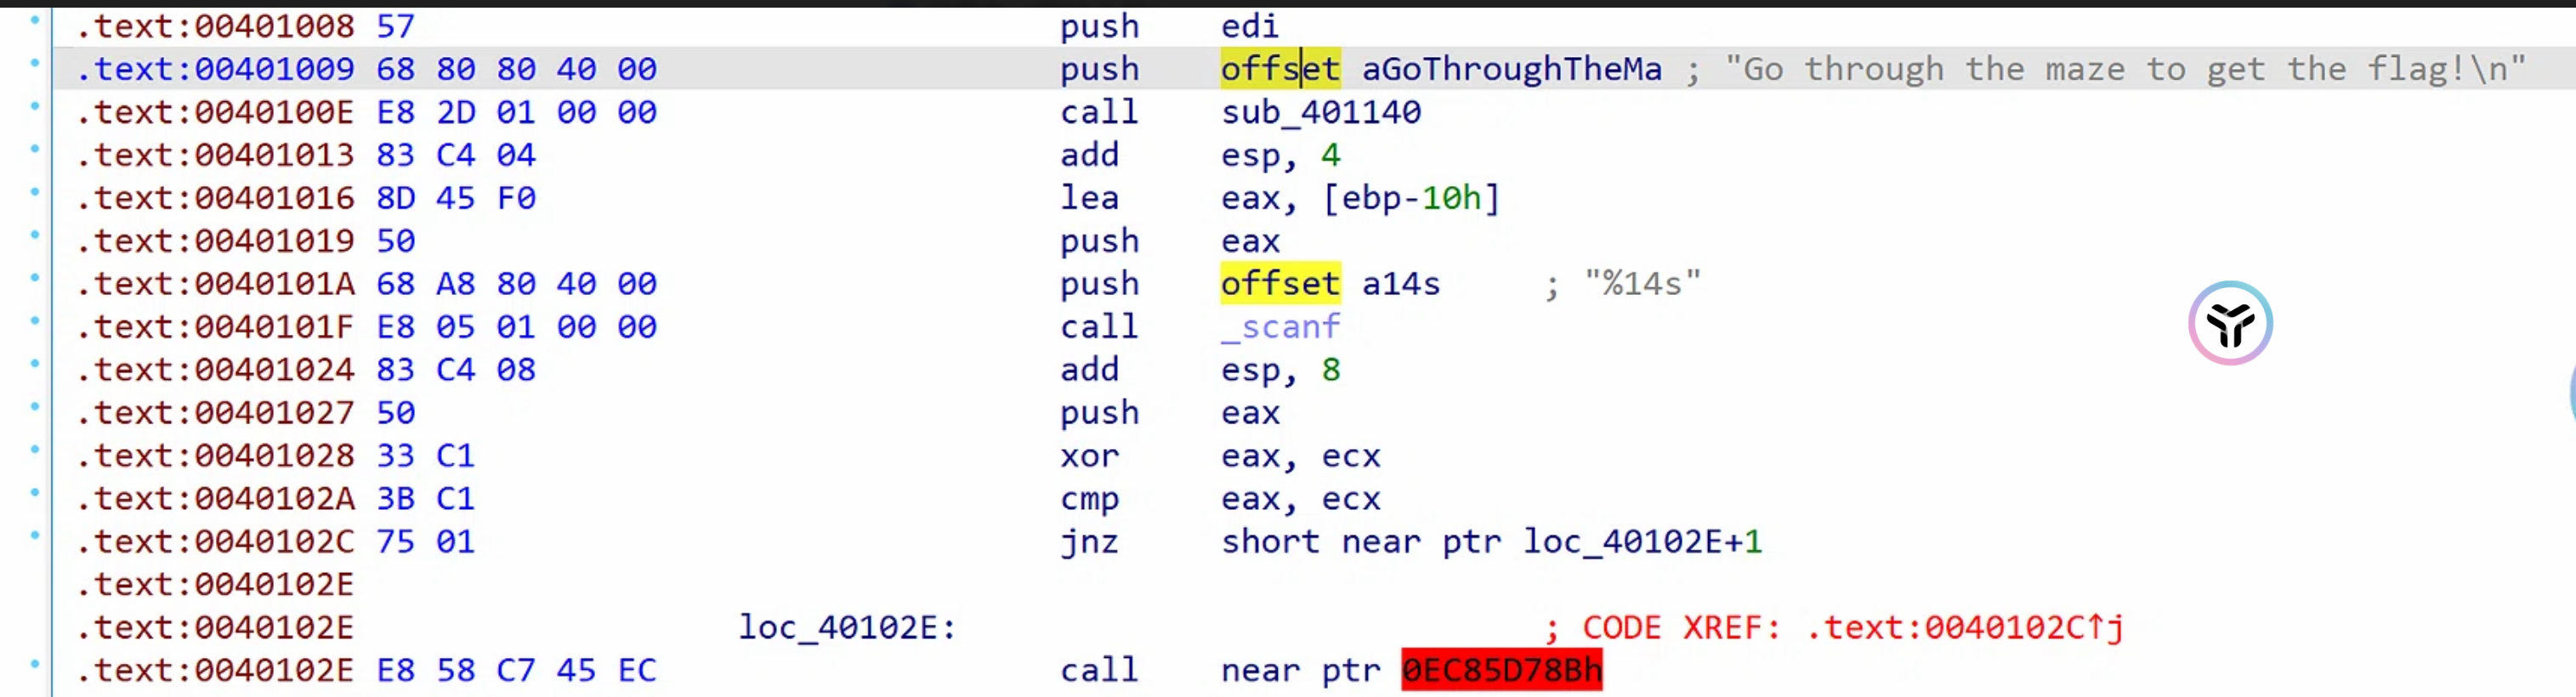
这里可以看到1027,把eax的值push到栈里了,也是花指令的开始。
然后抑或,比较作永真永假式,最后跳转,而且是跳转到了地址+1,也就是102E的58开始的位置(被精心设计过,后面的可以构成另一个语句)。
所以我们只需要从1027到102E的hex用90 nop替换即可。
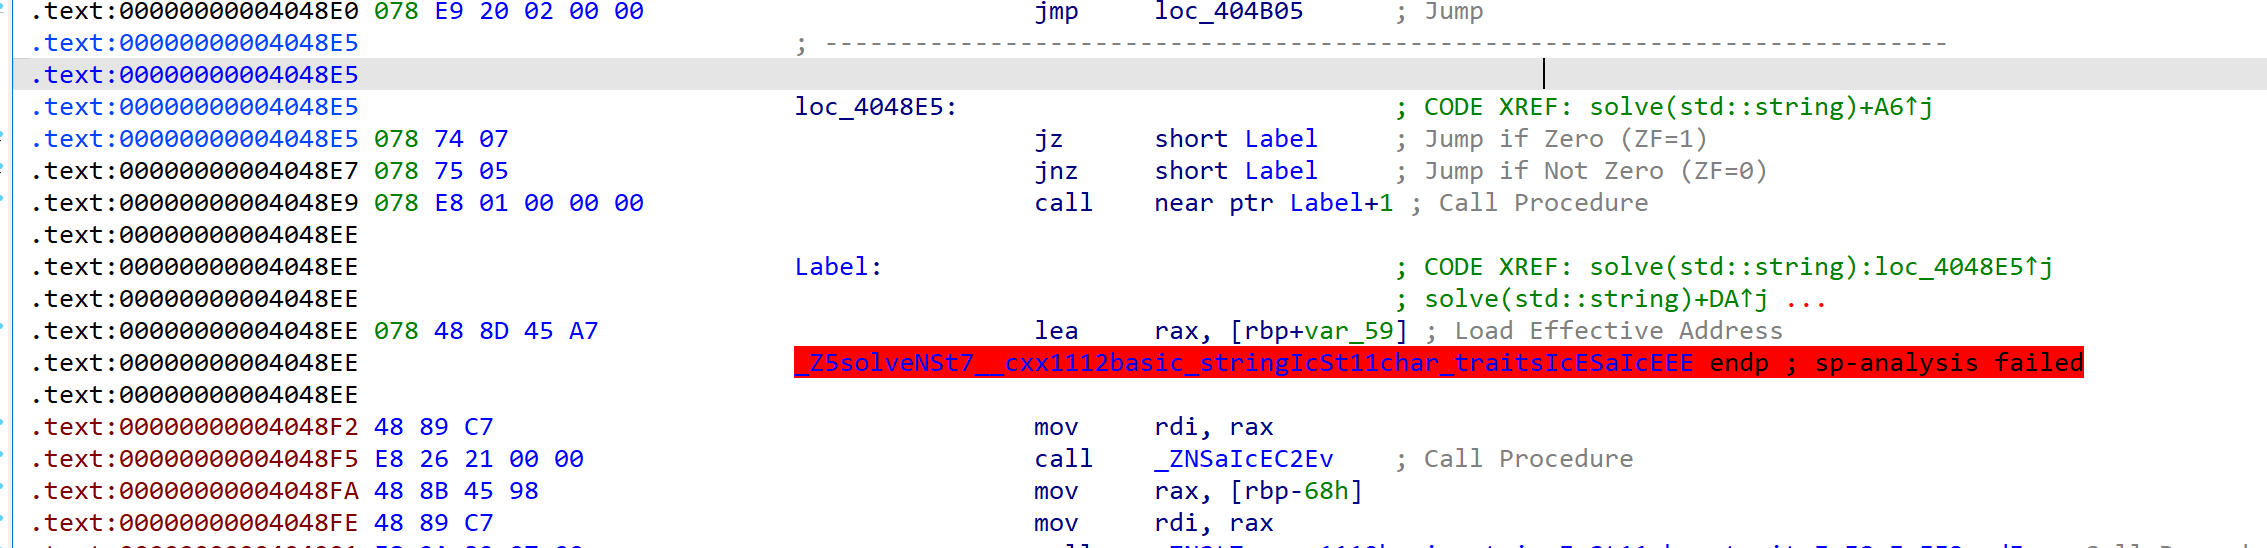
再看 moectf2025 的 flower 题目解法依旧,jz,jnz互相冲突,然后call又怼到+1的位置,直接全nop即可。