来源:【中国某省队 CTF 集训(逆向工程部分)(已授权)(一)】合集
https://www.bilibili.com/video/BV1qq4y1B7Kr/?share_source=copy_web&vd_source=1f5a7bcfe439d21ac9c4e6aca396949f笔记按视频期数整理(第一期 / 第二期 / 第三期);原始记录已备份为同目录《一组逆向视频教程的观看笔记 - 副本.md》。文末附【拓展与提醒】。
末尾存原笔记
目录
第一期:算法识别 · 花指令 · xref 跟踪
1.1 解题总流程
- 先判断题型。
- 如果是考加密,先根据题目特征判断加密算法。如果看到非常复杂的函数,不用一行行看——先抓特征常量、移位、异或结构。
1.2 TEA 和 XXTEA 的特点
| 算法 | 识别特征 |
|---|---|
| TEA | 特征常量 0x9E3779B9(Delta);左移 4、右移 5(包括以乘除形式表现出来的);”两个异或链接起的三部分” 结构 |
| XXTEA | 异或、移项在同一个式子里 |
TEA 加密结构图:

1.3 IDA 小技巧:竖排 WORD 数据转数组
碰到竖着列的 WORD 数据:右键 → Array,就能把它转化成好读的形式。
1.4 C 和 Python 的溢出差异
C 和 Python 的溢出行为不一样(负数取模也不一样),所以有时候脚本不能用 Python 写——比如 TEA 家族一般用 C 写。
1.5 脏字节(其实就是花指令)
特征与原理:
0xE8是call的字节码,软件就要往下找地址,有污染性;又如0xB8、0xFF等。- 跳转混淆:比如要跳到
0x1A,可以写成0x19 + 1——不会报错,但能骗过 IDA 等编译/反汇编软件。
IDA 按 U 可以取消分析,回到二进制码(原始字节)。
一种处理方式:
- 错的那行按
U; - 在有 xref 的这一行往下框选;
- 按
C(优先用 analysis),就可以弄出来。
其他方式:
- 也可以动调,可以看到代码。
- 如果能 analysis 就不用 nop 的那种方法了,直接
U+C即可。
1.6 利用 xref 跟踪
按 X 查看交叉引用:有 r(读)操作、w(写)操作,可以解那些嵌套的题目。
第二期:UPX 壳 · C++ 逆向
2.1 UPX 壳
- UPX 壳:把机器码加密,运行时解密。
- 脱壳后发现很多往上翻的死循环,往下转就行了。
2.2 C++ 逆向:分清作用域、函数
- 有些只用看 basic string(
std::string/basic_string模板)。 - 找尖括号(模板参数)。
- 分清楚作用域:顶级作用域、局部作用域……
- 碰到圆括号,看最前面的部分;中间可能有尖括号,可以无视。
for_each+ lambda 循环一般是在加密,lambda 在加密。
第三期:类型判定 · 阅读算法 · 动调 · 字节序
3.1 加密题的切入点
- 加密:如果判断出位数相同的话,就比较简单(等长变换,多半是可逆的轮函数/异或类)。
- 模其实就是小循环(取模 ≡ 循环取用的下标)。
3.2 判断变量类型
想知道一个变量到底是什么类型:双击它,在 .rodata 段看类型标识——dq(8 字节)、dw(2 字节)、dd(4 字节)等。
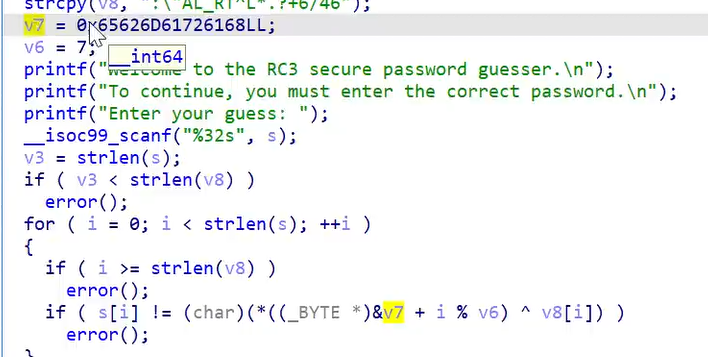
配合(示例:伪代码里 v7 = 0x65626D616C68LL,比较时 *((_BYTE *)&v7 + i % v6) 按字节取用):
见到强制转换不用太想改类型,容易改错,只要理解就行。
3.3 可以直接跳过的函数
read输入函数——不用看。fflush刷新——不用看。- 等等等
3.4 反编译出错时
发现反编译错误,那就只能看汇编了。
3.5 输入输出与调用约定
对于输入、输出、字符串:
- 64 位用
rdi、rsi(传参);鼠标放到变量上面可以看到是什么属性,动调的时候可以看到里面的变化情况。 - **x86(32 位)**用的是堆栈,
push传参。
3.6 已知方向,阅读算法
阅读加密逻辑时注意三类关键点:
memset等空间分配——memset对字符串进行空间分配,说明即将对字符串进行空间分配;有一些题,可能可以在里面动调看到答案。- return 点。
- 比较操作(字符串整体比较,如
strcmp类)。
3.7 动态调试要点
- 注意动调,关注 EIP 的跳转和变化,有时候 flag 在中间变量里。
- 可以改 EIP,跳到想要的位置。
int 3会卡死动调(程序内的反调试断点)。
3.8 字节序
- 小端序:
0x123456低位在右边;最低数据位放在最低地址。 - 大端:数据最高位放在地址最低位。
- 字符串:最低位是最左边的,相当于 0 偏移,和字符数组一样。
3.9 SIMD 相关(__m128i / xmmword)
- 看到
__m128i:开了优化(O3 优化),忽略掉。 - 看到
xmmword:开了优化,要从右往左读。
拓展与提醒(补充内容)
以下为整理时补充的拓展、勘误与实用提醒,不属于原笔记内容。
A. 原文笔误勘误
| 原文 | 应为 | 说明 |
|---|---|---|
| “大段,数据最高位放在地址最低位” | 大端(Big-Endian) | 笔误 |
| “可以调eip,跳到想到的位置” | 调试器中右键 Set IP here(或直接改 EIP/RIP 寄存器值) | 动调跳过比较/报错分支的规范叫法 |
B. TEA 家族识别与求解(扣回 1.2 / 1.4)
0x9E3779B9出自黄金分割比,TEA/XTEA/XXTEA 都用它;看到它基本可锁定 TEA 家族。魔改题通常改:delta 值、轮数(标准 32 轮)、密钥调度——先全局搜 delta,再数循环次数。- TEA 的结构正是图中所示 Feistel 变体:
v0 += ((v1<<4)+k0) ^ (v1+sum) ^ ((v1>>5)+k1),v1对称用k2/k3——对应”两个异或链接起的三部分”。 - 用 Python 写脚本必须手动截断 32 位:每步运算后
& 0xFFFFFFFF,且注意 C 的%向零取整、Python 的%向负无穷取整(1.4 的根源)。TEA 还有等效密钥缺陷(1 个密钥 ≈ 4 个等效密钥),部分题会利用。
C. 花指令补充(扣回 1.5)
- 常见脏字节速查:
0xE8(call)、0xE9(jmp)、0xB8(mov eax, imm32)、0x68(push imm32)、0xFF。它们都会让反汇编器”吃掉”后面的真实指令。 - 通用三板斧:①
U+ 框选 +C(本笔记方法);② 手工 NOP(Edit → Patch program或 keypatch);③ 写 IDAPython 脚本批量清理。 - 遇
int 3(3.7):这是程序自带反调试断点,可在调试器异常设置里把它传给程序处理,或直接 patch 掉0xCC。
D. 图 2(v7 立即数)的通用套路
*((_BYTE *)&v7 + i % v6) 这种写法 = 把一个大整数按小端序拆成字节当密钥循环用(v6 是密钥长度)。IDA 里 __int64 立即数当字符串读时,永远记得按小端从低字节往高读——这正好呼应 3.8 的字节序。写解密脚本时用 struct.pack('<Q', v7) 最稳。
E. 图 3(栈变量 db ? undefined)的处理
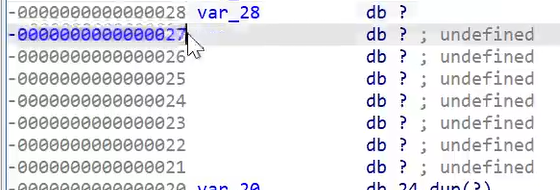
IDA 没识别出类型时,可以在栈帧/数据视图里:按 D 循环切换 db→dw→dd;选中一段按 *(或右键 Array)定义成数组;var_28 这类紧挨着的 db ? 往往就是一个缓冲区,结合 1.3 的 Array 操作一起用。
F. UPX 补充(扣回 2.1)
- 标准 UPX 先试
upx -d一键脱壳;脱不了说明魔改了 UPX 特征(如 magicUPX!被改、节名被改),先修特征再脱。 - 通用脱壳思路:ESP 定律、单步跟踪、内存断点——脱壳后 OEP 附近常是大量
pushad/pushfd与往上跳的死循环(对应”往下转就行了”)。
原笔记
【中国某省队CTF集训 (逆向工程部分)(已授权)(一)】 https://www.bilibili.com/video/BV1qq4y1B7Kr/?share_source=copy_web&vd_source=1f5a7bcfe439d21ac9c4e6aca396949f 合集
先判断题型
如果是考加密,先根据题目特征判断加密算法。如果看到非常复杂的函数,不用一行行看
TEA和XXTEA的特点
TEA
0x9e3779b9
左移四右移五(包括乘除表现出来的)
加密算法
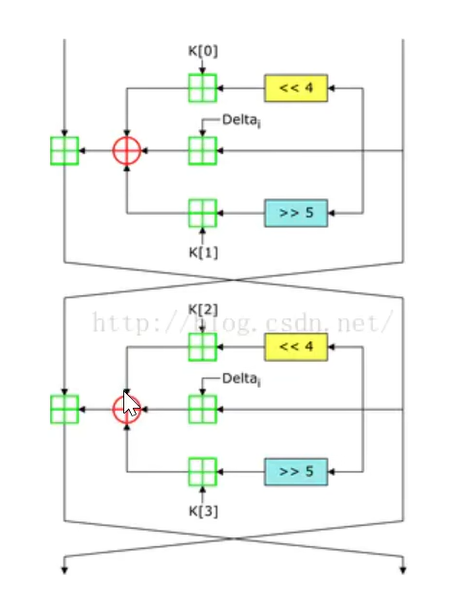
两个异或链接起的三部分
xxtea 异或,移项在一个式子里
ida 碰到竖着列的WORD数据,右键,点array就能把他转化成好读的形式
c和Python的溢出不一样(也比如负数取模),所以有时候脚本不能用Python写(比如TEA家族一般是用C写)
脏字节(其实就是花指令)
ida按U,可以取消分析,回到二进制码
0xE8注意,call的字节码,软件就要往下找地址。有污染性 又如0xb8,0xff等
或者比如说要跳到0x1A,可以写成0x19+1就不会报错,但是能骗ida等编译软件
一种处理方式
错的那行按u,在有xref这一行往下框选,然后按C,优先用analysis,就可以弄出来
也可以动调,可以看到代码
如果能analysis就不用nop的那种方法了,直接uc即可
利用xref跟踪
按x,有r操作,有w操作,可以解那些嵌套的题目
第二期
upx壳,把机器码加密,运行时解密
脱壳发现很多往上翻的死循环,往下转就行了
cpp逆向, 分清作用域,函数等
1.有些只用看basic string
2.找尖括号
分清楚作用域 顶级…..
碰到圆括号,看最前面,中间可能有尖括号,可以无视
for each lambda循环一般是在加密,lambda在加密咯
第三期
ida
加密,如果判断位数相同的话就比较简单
想知道一个变量到底是什么类型。可以双击,在rodata看类型 dq,dw,dd等
其实见到强制转换不用太想改类型,会错,只要理解就行
模其实就是小循环了
read输入函数,不用看
fflush 刷新,不用看
发现反编译错误,那就只能看汇编了
对于输入输出,字符串
64位用rdi rsi 鼠标放到变量上面可以看到是什么属性,在动调的时候可以看到里面的变化情况
x86用的是堆栈,push
已知方向,阅读算法,注意memset等空间分配,return点,比较操作(字符串整体比较)
原因
memset对字符串进行空间分配。即将对字符串进行空间分配了。有一些题,可能可以在里面动调看到答案
注意动调,关注eip跳和变化,有时候flag在中间变量
可以调eip,跳到想到的位置
int 3会卡死动调
小端序
0x123456 低位在右边。
小端 最低数据位就是最低地址位
大段,数据最高位放在地址最低位
字符串 最低位是最左边的,相当于0偏移,和字符数组一样
看了m128i 开了优化,o3优化。忽略掉
和xmmword,开了,要右到左